Как выбрать GPU-сервер для нейросетей и ИИ
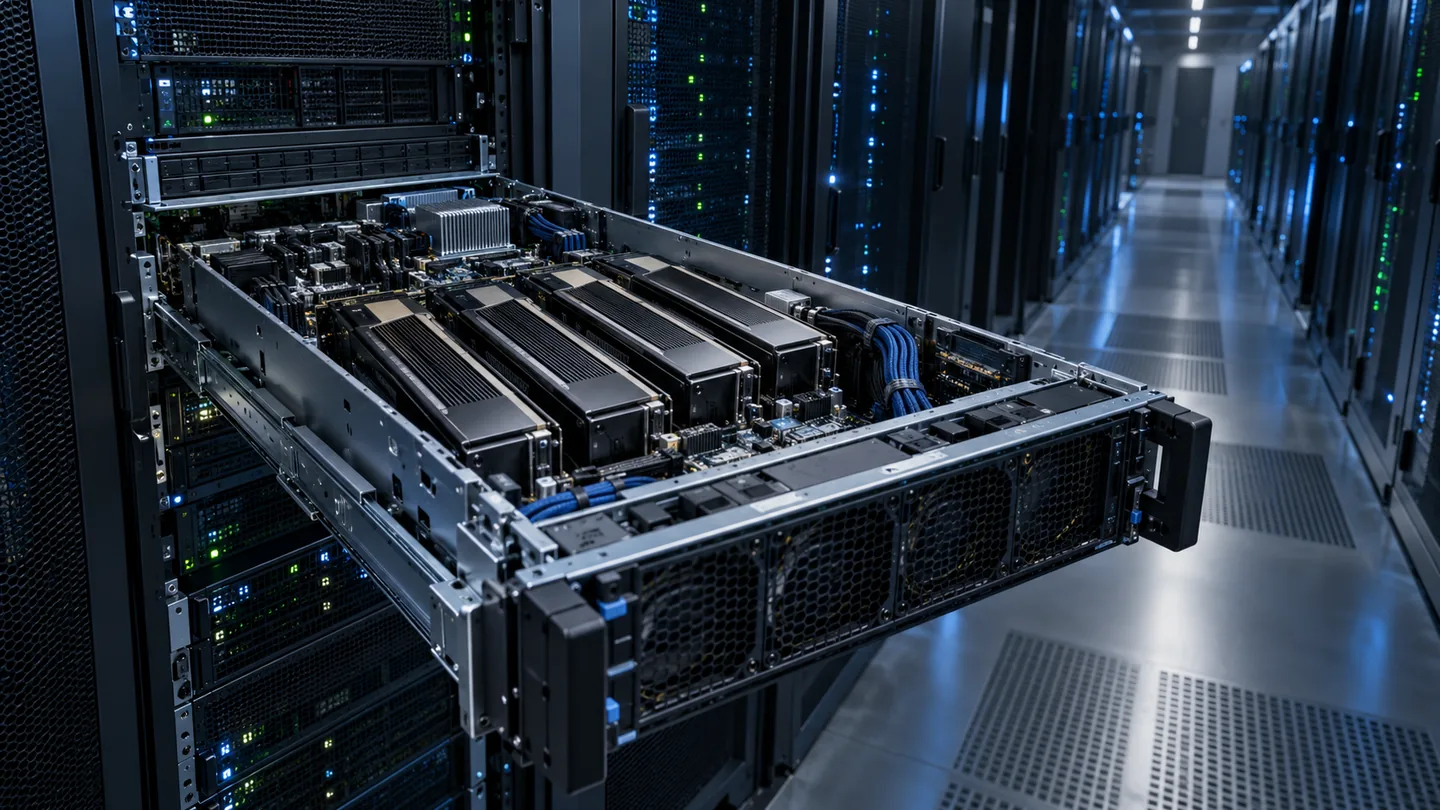
Сначала посчитайте, сколько видеопамяти съест ваша модель вместе с KV-кэшем, и только потом выбирайте карты. Для корпоративного ассистента на открытой модели среднего размера хватит 1–2 карт на 48–96 ГБ, для обучения и масштабирования нужны платформы на 4–8 GPU с NVLink и быстрой сетью между узлами.
Конфигурации GPU-серверов под разные задачи
| Задача | GPU | Процессор | Память | Сеть |
|---|---|---|---|---|
| Корпоративный ассистент, поиск по документам | 1–2 × L40S 48 ГБ или RTX PRO 6000 96 ГБ | 1 × Xeon / EPYC | 256–512 ГБ | — |
| Обучение и масштабирование | 4–8 × RTX PRO 6000 96 ГБ или H100 | 2 × Xeon / EPYC | от 1 ТБ | 100–400 GbE / InfiniBand |
| Платформа Supermicro AS-4125GS-TNRT | до 8 двухслотовых GPU по PCIe 5.0 × 16 | 2 × AMD EPYC 9004/9005 | до 6 ТБ ECC RDIMM | 2 × 10GbE RJ45 + BMC 1GbE |
Сколько видеопамяти нужно модели
Объём видеопамяти решает, запустится модель вообще. Модель должна целиком помещаться в память GPU: чем крупнее модель и больше одновременных запросов, тем больше суммарной видеопамяти понадобится. Поэтому карты на 48–96 ГБ выгоднее нескольких «игровых» — они дают нужный объём в одном слоте.
Считайте память под веса по числу параметров и байту на параметр: FP16/BF16 — 2 байта, 8-бит — 1 байт, 4-бит — около 0,5 байта. Для модели на 70 млрд параметров это около 140 ГБ в FP16, 70 ГБ в INT8 и 35 ГБ в INT4. Но реальные 4-битные файлы GGUF тяжелее теоретических 0,5 байта: та же модель в Q4_K_M занимает около 38–40 ГБ.
К весам добавляйте KV-кэш: он растёт линейно с длиной контекста и числом одновременных запросов. Для Llama 3.3 70B это около 2,6 ГБ при контексте 8K и около 41 ГБ при контексте 128K. Плюс активации и накладные расходы фреймворка — практическое правило закладывать 15–20 % сверху и не рассчитывать на 100 % заявленной памяти.
Отдельный случай — модели с архитектурой Mixture-of-Experts: они загружают в память все эксперты. «Активные» параметры ускоряют работу, но память не экономят, так что считать объём нужно по полному набору экспертов.
Серверные GPU вместо игровых
Серверные карты рассчитаны на работу 24/7, имеют память с коррекцией ошибок и охлаждение под плотную установку в стойку — несколько штук в одном корпусе без перегрева. Игровая карта в такой конфигурации не рассчитана на постоянную нагрузку и плотную компоновку.
Для карт RTX PRO 6000 Server Edition вычислительная мощность не помогает, если модель не помещается в память. Решающая характеристика для LLM — объём и пропускная способность видеопамяти: 1597 ГБ/с у RTX PRO 6000 против 864 ГБ/с у L40S.
Смотрите на конкретные параметры карт. NVIDIA L40S: 48 ГБ GDDR6 с ECC, пропускная способность 864 ГБ/с, архитектура Ada Lovelace, PCIe Gen4 × 16, двухслотовая, до 350 Вт, FP32 91,6 ТФлопс, FP16 Tensor Core 362 ТФлопс (733 ТФлопс с разрежённостью).
NVIDIA RTX PRO 6000 Blackwell Server Edition: 96 ГБ GDDR7 с ECC, интерфейс памяти 512 бит, пропускная способность 1597 ГБ/с, до 600 Вт (настраиваемо), PCIe Gen5, до 4 изолированных экземпляров MIG, FP4 4 ПФлопс, FP8 2 ПФлопс. Есть воздушный двухслотовый и жидкостный однослотовый варианты.
Платформа: сколько GPU ставить
Для корпоративного ИИ-ассистента, поиска по документам и распознавания хватит 1–2 карт NVIDIA L40S 48 ГБ или RTX PRO 6000 96 ГБ, одного процессора Xeon или EPYC и 256–512 ГБ памяти. Открытые модели среднего размера работают локально, без облака, а NVMe ставят под модели и векторную базу.
Для обучения и масштабирования нужны платформы на 4–8 карт RTX PRO 6000 96 ГБ или H100, два процессора Xeon или EPYC и от 1 ТБ памяти. Здесь важны NVLink и кластер из нескольких узлов с быстрой сетью между ними — 100–400 GbE или InfiniBand.
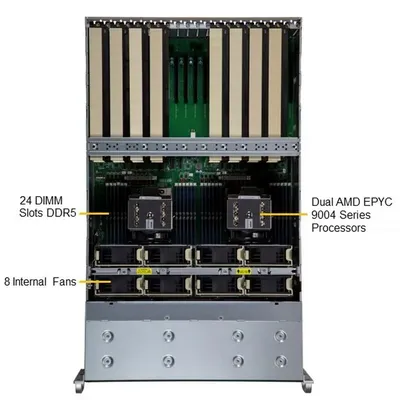
Пример платформы — Supermicro AS-4125GS-TNRT: корпус 4U, два процессора AMD EPYC 9004/9005 (до 400 Вт каждый, до 160 ядер на сокет), 24 слота DDR5 (до 6 ТБ ECC RDIMM), до 8 двухслотовых GPU полной длины, подключённых напрямую по PCIe 5.0 × 16. Список поддерживаемых GPU включает NVIDIA L4, L40S, RTX PRO 4000/4500/5000/6000 Blackwell, RTX 4000–6000 Ada и AMD Instinct MI210, Radeon AI PRO R9700S; опционально NVLink Bridge.
По дискам и слотам: 6 передних отсеков горячей замены (по умолчанию 2 × SATA и 4 × NVMe 2,5 дюйма), один слот M.2 PCIe 3.0 × 4, 9 слотов PCIe 5.0 × 16 FHFL, до 8 вентиляторов. Сеть — 2 × 10GbE RJ45 и выделенный порт BMC 1GbE.
Питание и охлаждение серверной
Сервер на 4–8 GPU потребляет 3–10 кВт, поэтому перед закупкой проверяют, выдержит ли ваша серверная, и подбирают ИБП и стойку. Проект серверной с питанием и охлаждением — часть подбора, а не формальность после поставки.
Считайте по паспортным TDP. 8 карт RTX PRO 6000 по 600 Вт — это 4800 Вт только на GPU, что выше 4000 Вт, доступных в режиме 2+2 блоков питания AS-4125GS-TNRT. 8 карт L40S по 350 Вт дают 2800 Вт, плюс два процессора до 400 Вт — вписывается в бюджет. Итоговую конфигурацию проверяет производитель.
У AS-4125GS-TNRT четыре блока питания по 2000 Вт Titanium (КПД 96 %) с резервированием 3+1; при конфигурации 2+2 доступно до 4000 Вт. Габариты корпуса 7 × 17,2 × 29 дюймов, масса 29,7 кг.
Локально или в облаке
Свой сервер держит данные внутри компании: документы, переписка и базы клиентов не уходят сторонним сервисам. Это ключевой аргумент для организаций, которые работают с чувствительными данными.
Пример: модель на 70 млрд параметров в FP8 для корпоративного ассистента
Условия: открытая модель на 70 млрд параметров, контекст 8K, один узел, задача — корпоративный ассистент и поиск по документам.
Шаг 1. Веса в FP8: 70 млрд параметров × 1 байт = 70 ГБ.
Шаг 2. KV-кэш при контексте 8K — около 2,6 ГБ.
Шаг 3. Запас 20 %: (70 + 2,6) × 1,2 ≈ 87 ГБ.
Вывод: 87 ГБ помещаются на одной карте RTX PRO 6000 Blackwell (96 ГБ), но не на L40S (48 ГБ). Если та же модель нужна в FP16, веса вырастут до 140 ГБ, с KV-кэшем и запасом выйдет около 171 ГБ — понадобятся 2 карты RTX PRO 6000 (2 × 96 = 192 ГБ) или 4 карты L40S (4 × 48 = 192 ГБ).
Частые ошибки при выборе
- Ориентироваться на ТФлопс и не считать память — модель, не помещающаяся в видеопамять, не запустится или уйдёт в медленную оперативную память.
- Считать только веса и забывать KV-кэш — при контексте 128K кэш модели на 70 млрд параметров достигает около 41 ГБ.
- Ставить 8 мощных GPU без расчёта блоков питания и охлаждения — суммарный TDP может превысить доступную мощность при резервировании.
- Квантовать модель в 4-бит без проверки качества — INT4 требует проверки точности на конкретной модели.
- Брать игровые карты вместо серверных — они не рассчитаны на работу 24/7 и плотную установку в стойку.
- Забывать про накладные расходы фреймворка — закладывайте 15–20 % сверху и не рассчитывайте на 100 % заявленной памяти.
Что выбрать
- Корпоративный ассистент и поиск по документам на открытой модели среднего размера1–2 × NVIDIA L40S 48 ГБ, 1 × Xeon или EPYC, 256–512 ГБ памяти, NVMe под модели и векторную базуМодели среднего размера помещаются в 48 ГБ, карта рассчитана на работу 24/7
- Модель на 70 млрд параметров в FP8 с контекстом 8K1 × NVIDIA RTX PRO 6000 Blackwell 96 ГБ87 ГБ с запасом помещаются в 96 ГБ одной карты
- Модель на 70 млрд параметров в FP162 × RTX PRO 6000 96 ГБ или 4 × L40S 48 ГБОколо 171 ГБ с запасом требуют 192 ГБ суммарной видеопамяти
- Обучение и масштабирование на нескольких узлахSupermicro AS-4125GS-TNRT с 4–8 GPU, NVLink и сетью 100–400 GbE или InfiniBandДо 8 двухслотовых GPU по PCIe 5.0 × 16 и два EPYC 9004/9005
Частые вопросы
Можно ли запустить модель на 70 млрд параметров на одной карте L40S 48 ГБ?
Нет, в FP8 и FP16 не поместится. В 4-бит модель занимает около 38–40 ГБ, но с KV-кэшем и запасом выходит около 50 ГБ — выше 48 ГБ, поэтому нужна карта с большей памятью или две карты.
Хватит ли одной L40S для модели на 8 млрд параметров?
Да, с большим запасом. В FP16 такая модель занимает около 16 ГБ — 2 ГБ на 1 млрд параметров.
Почему нельзя взять несколько игровых карт вместо одной серверной?
Серверные карты рассчитаны на работу 24/7, имеют память с коррекцией ошибок и охлаждение под плотную установку в стойку. Игровые на такую нагрузку и компоновку не рассчитаны.
Что важнее для LLM — ТФлопс или объём памяти?
Объём и пропускная способность памяти. Модель, не помещающаяся в видеопамять, не запустится или уйдёт в медленную оперативную память, и вычислительная мощность уже не поможет.
Сколько карт RTX PRO 6000 можно поставить в AS-4125GS-TNRT?
До 8 двухслотовых GPU полной длины. Но 8 карт по 600 Вт дают 4800 Вт только на GPU — это выше 4000 Вт, доступных в режиме 2+2 блоков питания, поэтому конфигурацию проверяет производитель.
Нужен ли NVLink для инференса?
Для одного узла с несколькими GPU NVLink Bridge у AS-4125GS-TNRT опционален. Для обучения и масштабирования на нескольких узлах важнее NVLink и быстрая сеть между ними.
 −5%
Нужна помощь с выбором?
Подберём технику под задачу, подготовим спецификацию и коммерческое предложение — для бизнеса и госзаказчиков, с поставкой по России.